Vai al contenuto

Market intelligence event-driven

QuantPulse

Progetto personale · 2026 · Java 21, Spring Boot, RabbitMQ, PostgreSQL

In breve

QuantPulse è una piattaforma di market intelligence event-driven per la Borsa di Casablanca: quattro servizi Spring Boot su una dorsale RabbitMQ, uno storage PostgreSQL, un servizio di analisi in Python e una dashboard Next.js.

La parte interessante non è la finanza. È che il piano gratuito del fornitore dei dati consente 100 richieste al giorno — e che quel solo numero governa quasi ogni decisione strutturale del sistema.

Il problema

Coprire tutti gli 81 strumenti quotati con un budget di 100 chiamate al giorno esclude subito il progetto ovvio. Una richiesta per titolo a ogni aggiornamento esaurisce il budget prima che il mercato sia aperto da un'ora, e non c'è logica di retry che corregga un'aritmetica.

Il progetto ruota attorno a un'osservazione nata dal leggere seriamente l'API del fornitore: GET /stocks?limit=200 restituisce tutti gli 81 strumenti in una sola chiamata. Un'istantanea completa del mercato costa una richiesta, non 81. Questo trasforma un problema impossibile in un budget pianificabile — circa 65 chiamate al giorno fra istantanee ogni 15 minuti durante la seduta, indici e un recupero dello storico di fine giornata gestito a coda di priorità.

Il secondo problema discende dal primo: se il budget è così stretto, sviluppo e test non possono spenderne. Entrambi girano interamente su 36 fixture registrate; un mvn verify completo fa zero chiamate reali.

Anteprima del prodotto

Panoramica del mercato
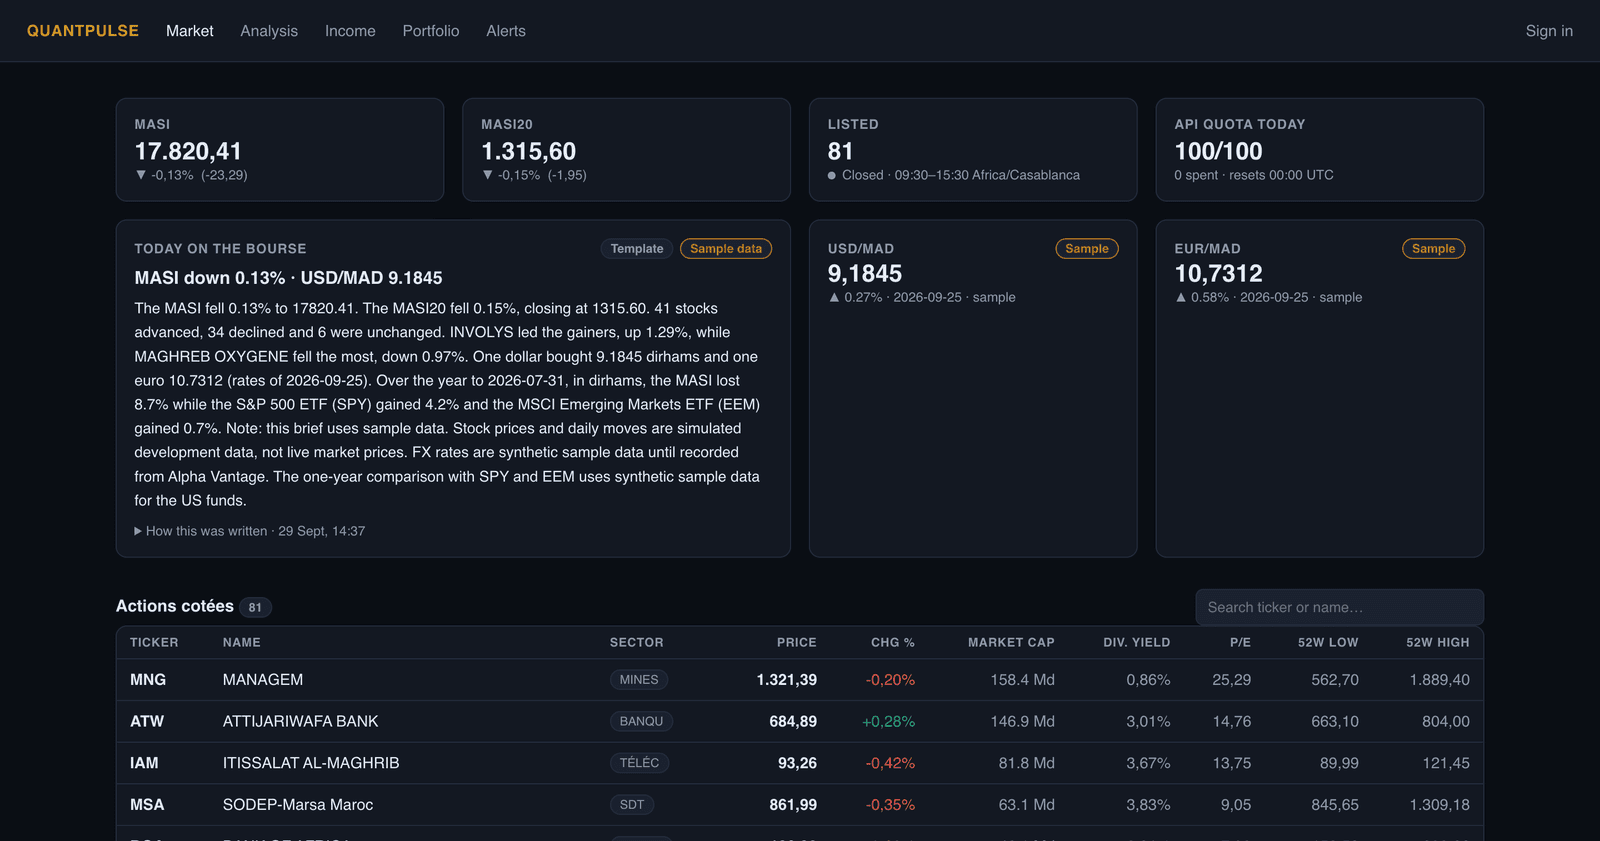
Panoramica del mercato — Il MASI, il MASI20, il resoconto del giorno e tutti gli 81 titoli quotati, con un indicatore che segue in tempo reale il budget di 100 richieste — ogni cifra sintetica è etichettata come tale, mai presentata come un prezzo reale.
Dettaglio di un titolo
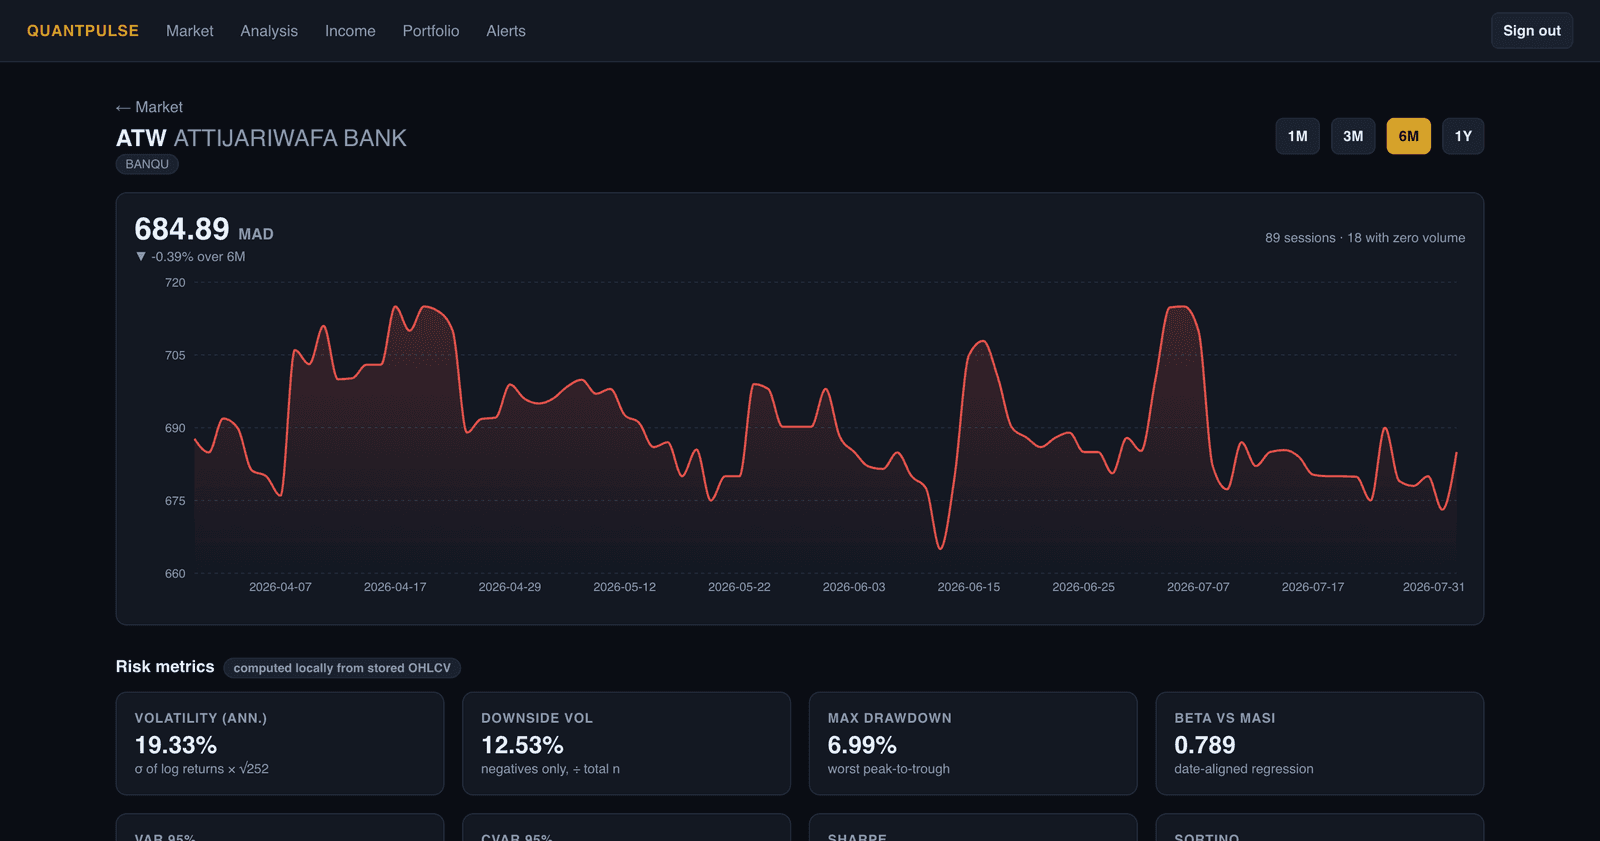
Dettaglio di un titolo — Sei mesi di ATW con, sotto, le metriche di rischio — volatilità, volatilità al ribasso, drawdown massimo, beta — calcolate localmente dagli OHLCV memorizzati, senza recuperare nulla altrove.
Casablanca contro il mondo
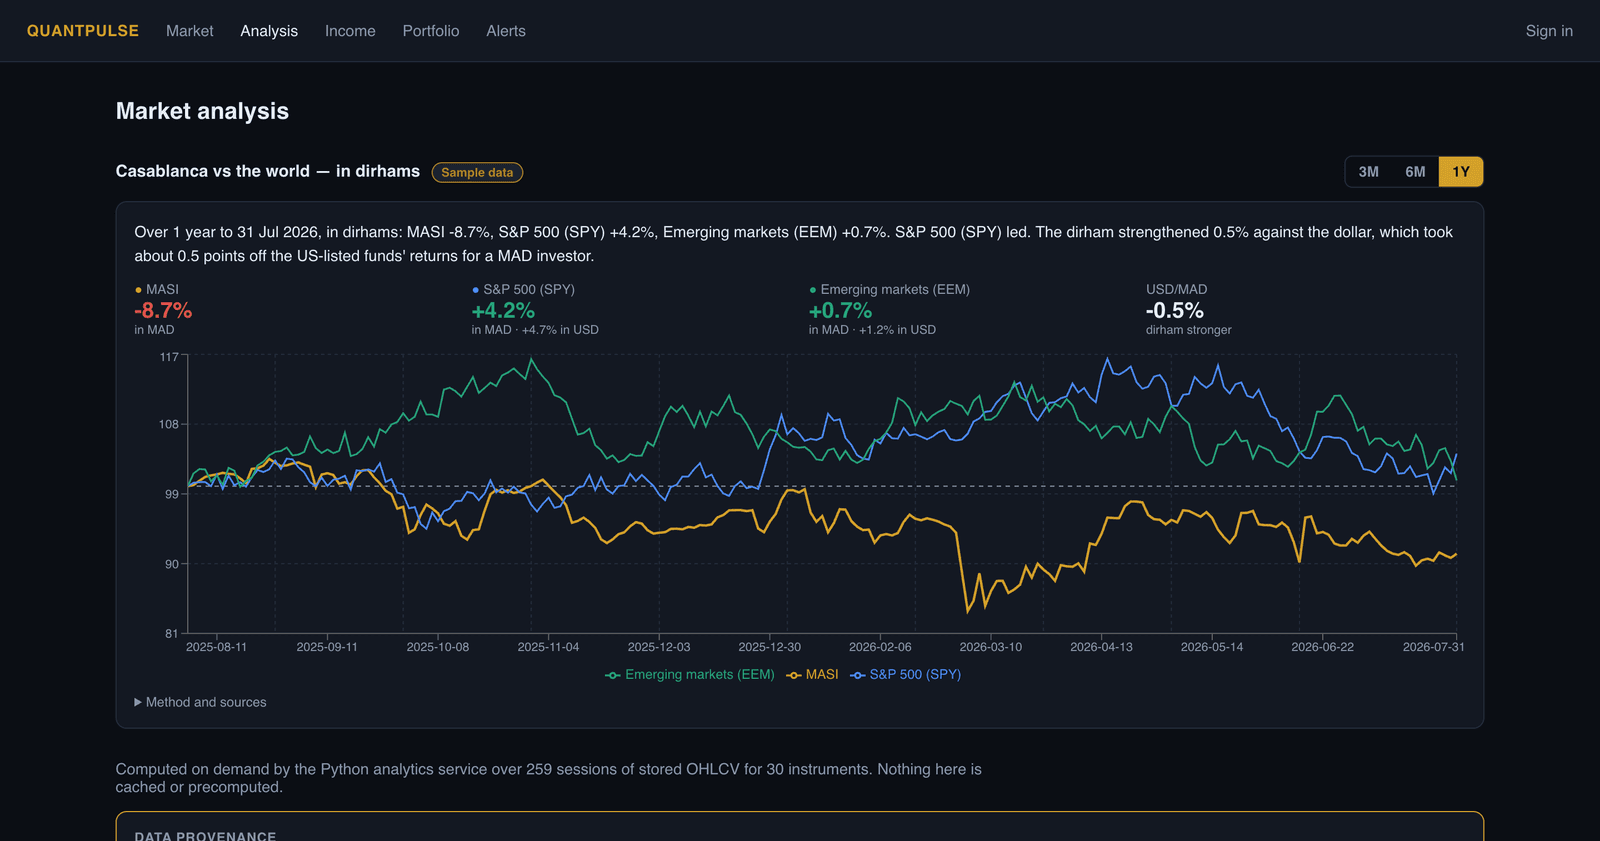
Casablanca contro il mondo — Il MASI confrontato con l'S&P 500 e l'MSCI Emerging Markets, riportati alla stessa valuta e alla stessa data di partenza, calcolato su richiesta su 259 sessioni memorizzate — niente qui è in cache o precalcolato.
Reddito da dividendi
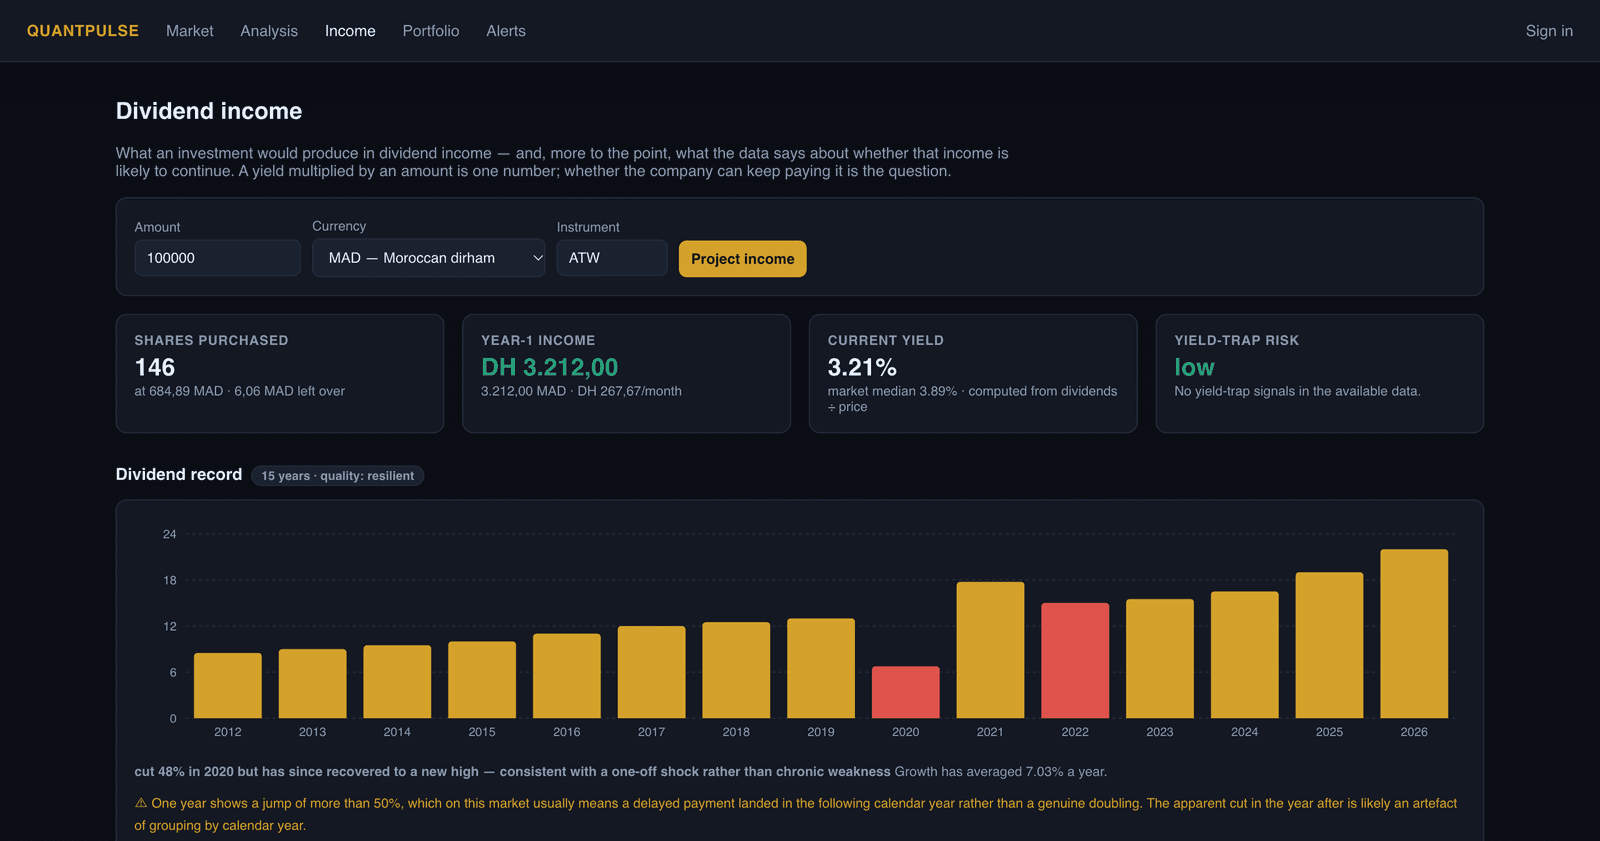
Reddito da dividendi — Un rendimento moltiplicato per un importo è un numero; la domanda che conta è se quel pagamento continuerà — lo storico di 15 anni segnala il taglio del 2020 come uno shock isolato, non una debolezza cronica.
Gestione del portafoglio
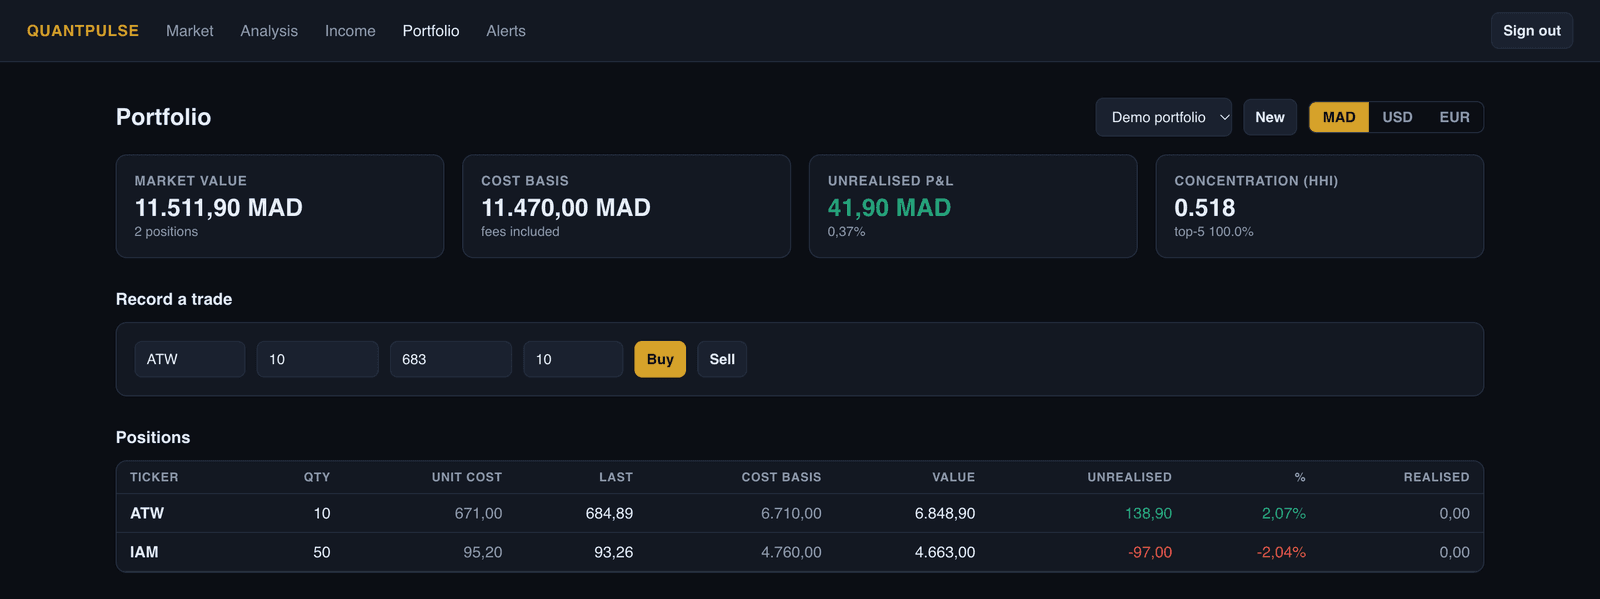
Gestione del portafoglio — Posizioni, costo di carico e plusvalenza non realizzata su uno storico di operazioni reale, valorizzati a scelta in MAD, USD o EUR.
Avvisi di prezzo
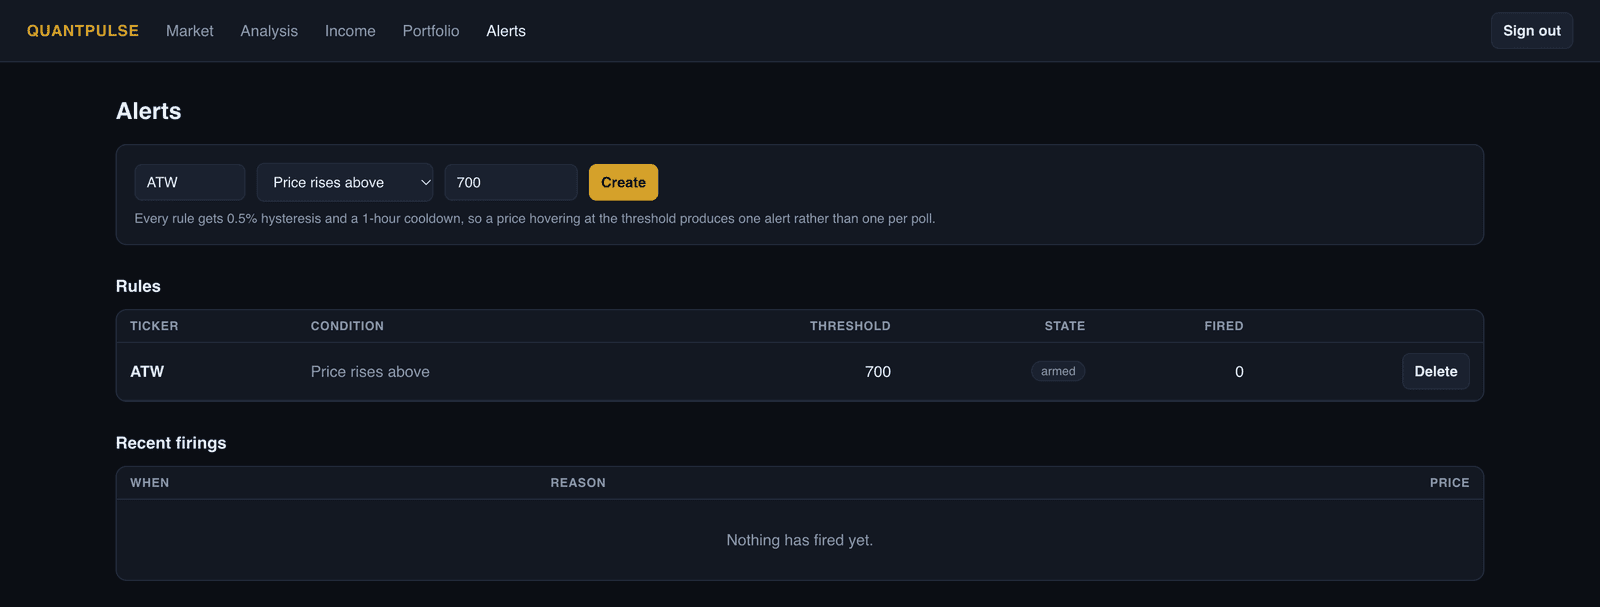
Avvisi di prezzo — Una regola armata su ATW sopra 700 MAD — un'isteresi dello 0,5% e un raffreddamento di un'ora evitano che un prezzo in bilico sulla soglia scateni un avviso a ogni interrogazione.

Architettura

API Drahmi100 richieste/giorno · differitegovernatore di quota · circuit breaker · cache L1+L2qp-marketdataunico proprietario del flussoqp-quantPython · PCA, Monte Carlooutbox transazionaleRabbitMQtopic exchange · DLQ · parking lotqp-portfolioaritmetica del denaroqp-alertselaborazione di flussoqp-apiBFF · unico servizio raggiungibileqp-webdashboard Next.jsuno schema e un ruolo di accesso per servizio — nessun permesso fra schemi

Un solo servizio possiede il flusso a quota limitata; tutto ciò che sta a valle apprende lo stato del mercato dagli eventi, mai dal fornitore.

Quattro servizi Spring Boot e un servizio Python, ciascuno con una ragione per essere separato.

  • qp-marketdata è l'unico componente che parla con il flusso a quota limitata e l'unico a scrivere dati di mercato. Un solo posto in cui spendere una richiesta significa un solo posto in cui far rispettare un budget. Davanti al fornitore: un governatore di quota, un circuit breaker Resilience4j e una cache a due livelli (Caffeine in-process, Redis condivisa) con TTL calibrati sul ritardo dei dati a monte.
  • Outbox transazionale. La scrittura del dato e la pubblicazione dell'evento sono un'unica decisione atomica. Senza, un crash fra le due lascia il database e il resto del sistema in disaccordo permanente.
  • RabbitMQ — un topic exchange dichiarato esplicitamente, con dead-letter queue e un parking lot per i messaggi che falliscono ripetutamente.
  • qp-portfolio possiede l'aritmetica del denaro e l'integrità transazionale; qp-alerts fa elaborazione di flusso. Entrambi apprendono lo stato del mercato dagli eventi.
  • qp-api è un backend-for-frontend con JWT e server-sent event, ed è l'unico servizio che il browser può raggiungere. qp-web è la dashboard Next.js.
  • qp-quant (Python, FastAPI, NumPy/scikit-learn) fa le analisi che sulla JVM sarebbero una sofferenza.
  • Una sola istanza Postgres, uno schema e un ruolo di accesso per servizio, senza permessi fra schemi. Lo storico OHLCV è partizionato per mese. Lo scheduling tiene conto degli orari di mercato in Africa/Casablanca, con ShedLock perché un'istanza replicata non spenda la quota due volte. Micrometer → Prometheus → Grafana dall'inizio alla fine.

Decisioni e compromessi

Uno schema per servizio, imposto dal database

Servizi separati che condividono uno schema sono il modo classico di costruire un monolite distribuito: il confine esiste nel diagramma e in nessun altro posto. Qui ogni servizio ha il proprio schema e il proprio ruolo di accesso, e non esiste alcun permesso fra schemi — qp_portfolio che interroga market.* fallisce con permission denied. L'anti-pattern non è sconsigliato: è impossibile per costruzione. Il costo è che condividere un dato richiede un atto deliberato — un evento, o una chiamata API. Ed è esattamente il punto.

Un outbox transazionale invece della pubblicazione dopo il commit

Pubblicare subito dopo il commit è una riga di codice ed è sbagliato in un modo che si manifesta solo nei guasti: un crash fra le due e la riga esiste mentre l'evento non è mai avvenuto. Scrivere l'evento nella stessa transazione del dato e inoltrarlo separatamente rende i due coerenti per costruzione. Il prezzo è una consegna at-least-once, quindi ogni consumatore dev'essere idempotente — una proprietà che vorrei comunque, e molto più facile da ragionare di un database che diverge in silenzio.

Un servizio Python separato per l'analisi

Mescolare runtime è un costo che si paga per sempre, quindi andava giustificato. La giustificazione è che PCA, clustering gerarchico, simulazione Monte Carlo e ottimizzazione di Markowitz sono un problema risolto in NumPy/SciPy/scikit-learn e un progetto di ricerca sulla JVM. qp-quant legge gli OHLCV tramite l'API HTTP di qp-marketdata invece di entrare nel suo database: il confine è un contratto, non una tabella condivisa.

Le previsioni restituiscono distribuzioni, mai un punto

Il servizio di analisi restituisce bande percentili e probabilità di esito da un Monte Carlo sotto GBM — mai «il prezzo sarà X». Accanto gira un backtest di calibrazione walk-forward, fuori campione, che dice se gli intervalli del modello sono onesti.

Quel backtest si è guadagnato il posto subito: ha trovato un difetto reale nella prima implementazione, dove una volatilità equipesata produceva intervalli al 90% che contenevano il 100% degli esiti — troppo larghi per essere utili, e sbagliati nella direzione lusinghiera. Ha portato al passaggio a EWMA. L'eccesso di fiducia residuo sullo strumento più volatile è riportato, non nascosto.

Cosa è stato difficile

La semantica di consegna. At-least-once significa che il consumatore di persistenza prima o poi vedrà due volte lo stesso tick, e una riga di prezzo duplicata è un grafico silenziosamente sbagliato, non un crash — il peggior modo di fallire che esista. Scritture idempotenti su una chiave naturale sono state la soluzione, e hanno cambiato il mio modo di scrivere consumatori: dare per scontato di essere chiamati due volte.

Il rate limit è stata l'altra difficoltà, in un modo che non mi aspettavo. Leggere con attenzione la documentazione del fornitore ha reso più di qualunque astuzia di caching — e la documentazione e l'API reale divergono in 11 punti documentati, che ho dovuto trovare e annotare uno a uno. Sviluppare contro un set di fixture registrate dal servizio vero è stato l'unico modo di procedere senza bruciare il budget della giornata prima di pranzo.

Risultato

Una piattaforma funzionante che copre l'intero listino dentro un budget che esclude il progetto ingenuo, con 69 test automatici e un mvn verify completo che spende zero chiamate API. Le analisi sono state confrontate con la realtà anziché presupposte: le metriche di rischio corrispondono ai valori pubblicati dal fornitore entro circa il 2%, e il clustering non vede mai le etichette di settore — quindi dove concorda con la classificazione settoriale ufficiale, quell'accordo è una prova e non un'ipotesi inserita in partenza.

È il primo sistema in cui ho scelto i modi di guasto di proposito, invece di scoprirli.

I prossimi passi

Non sto distribuendo questo progetto pubblicamente. Sei servizi, un broker e tre datastore sono infrastruttura vera da pagare e mantenere, per un progetto il cui compito è essere letto, non servire traffico. Gli screenshot qui sopra mostrano il sistema realmente in esecuzione; il RUNBOOK è la stessa sequenza di comandi che lo avvia per intero da un clone pulito in pochi minuti — sulle fixture registrate, zero chiamate al vero fornitore a monte. Ciò che vale ancora la pena fare sul sistema stesso: il tracing distribuito attraverso il confine del broker, perché un sistema interamente asincrono senza tracing è una brutta combinazione; e un percorso di replay per il parking lot, così che un messaggio avvelenato sia recuperabile e non solo contenuto.