Aller au contenu

Intelligence de marché événementielle

QuantPulse

Projet personnel · 2026 · Java 21, Spring Boot, RabbitMQ, PostgreSQL

En bref

QuantPulse est une plateforme d'intelligence de marché événementielle pour la Bourse de Casablanca : quatre services Spring Boot sur une dorsale RabbitMQ, un stockage PostgreSQL, un service d'analyse en Python et un tableau de bord Next.js.

L'intérêt n'est pas la finance. C'est que l'offre gratuite du fournisseur de données autorise 100 requêtes par jour — et que ce seul chiffre commande presque toutes les décisions structurelles du système.

Le problème

Couvrir les 81 instruments cotés avec un budget de 100 appels par jour exclut immédiatement la conception évidente. Une requête par action et par rafraîchissement épuise le budget avant que le marché ne soit ouvert depuis une heure, et aucune logique de réessai ne corrige une arithmétique.

La conception repose sur une observation faite en lisant sérieusement l'API du fournisseur : GET /stocks?limit=200 renvoie les 81 instruments en un seul appel. Un instantané complet du marché coûte une requête, pas 81. Cela transforme un problème impossible en un budget que je peux planifier — environ 65 appels par jour pour des instantanés toutes les 15 minutes pendant la séance, les indices, et une reprise d'historique de fin de journée par file de priorité.

Le second problème découle du premier : si le budget est aussi serré, le développement et les tests ne peuvent pas en dépenser. Les deux tournent entièrement sur 36 fixtures enregistrées ; un mvn verify complet fait zéro appel réel.

Aperçu du produit

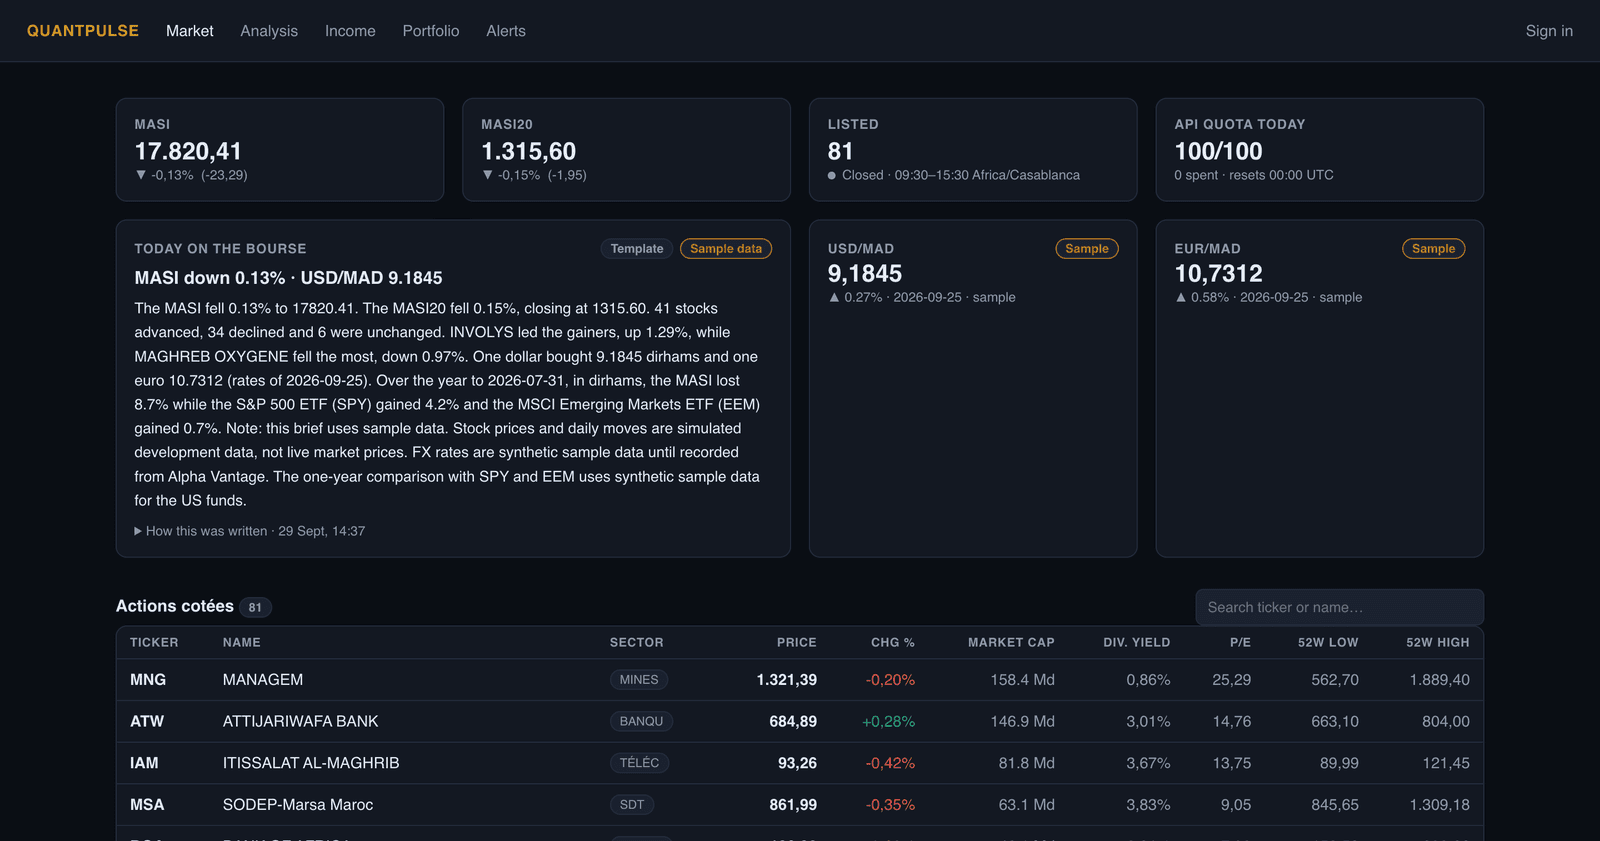
Vue d'ensemble du marché
Vue d'ensemble du marché — Le MASI, le MASI20, la synthèse du jour et les 81 valeurs cotées, avec une jauge de quota qui suit le budget de 100 requêtes en temps réel — chaque chiffre synthétique est signalé comme tel, jamais présenté comme un cours réel.
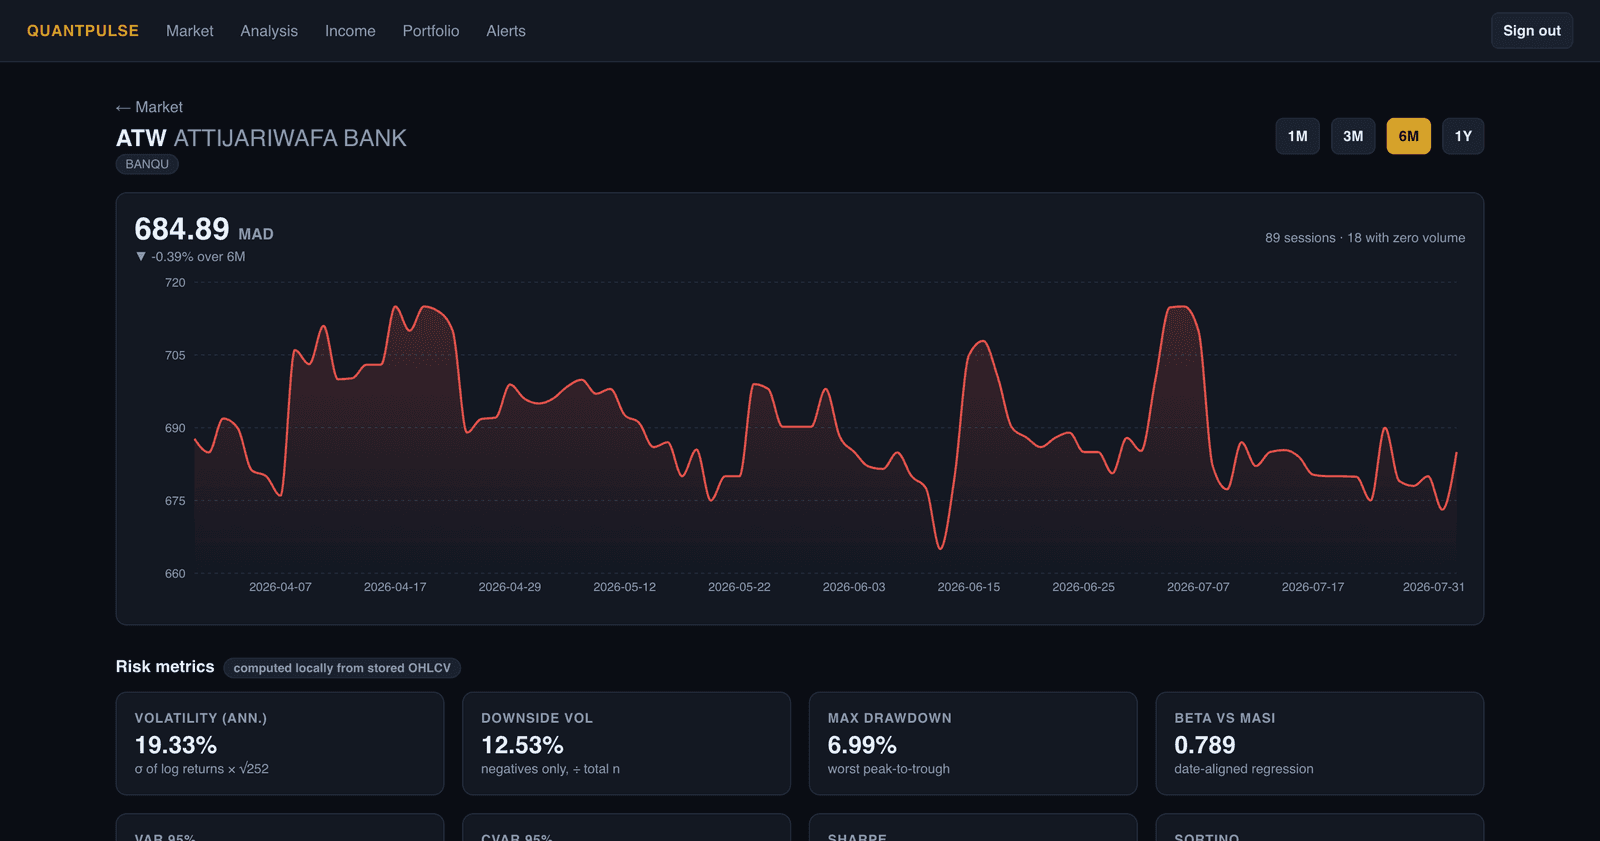
Détail d'une valeur
Détail d'une valeur — Six mois d'ATW avec, en dessous, les indicateurs de risque — volatilité, volatilité à la baisse, drawdown maximal, bêta — calculés localement à partir de l'OHLCV stocké, sans rien aller chercher ailleurs.
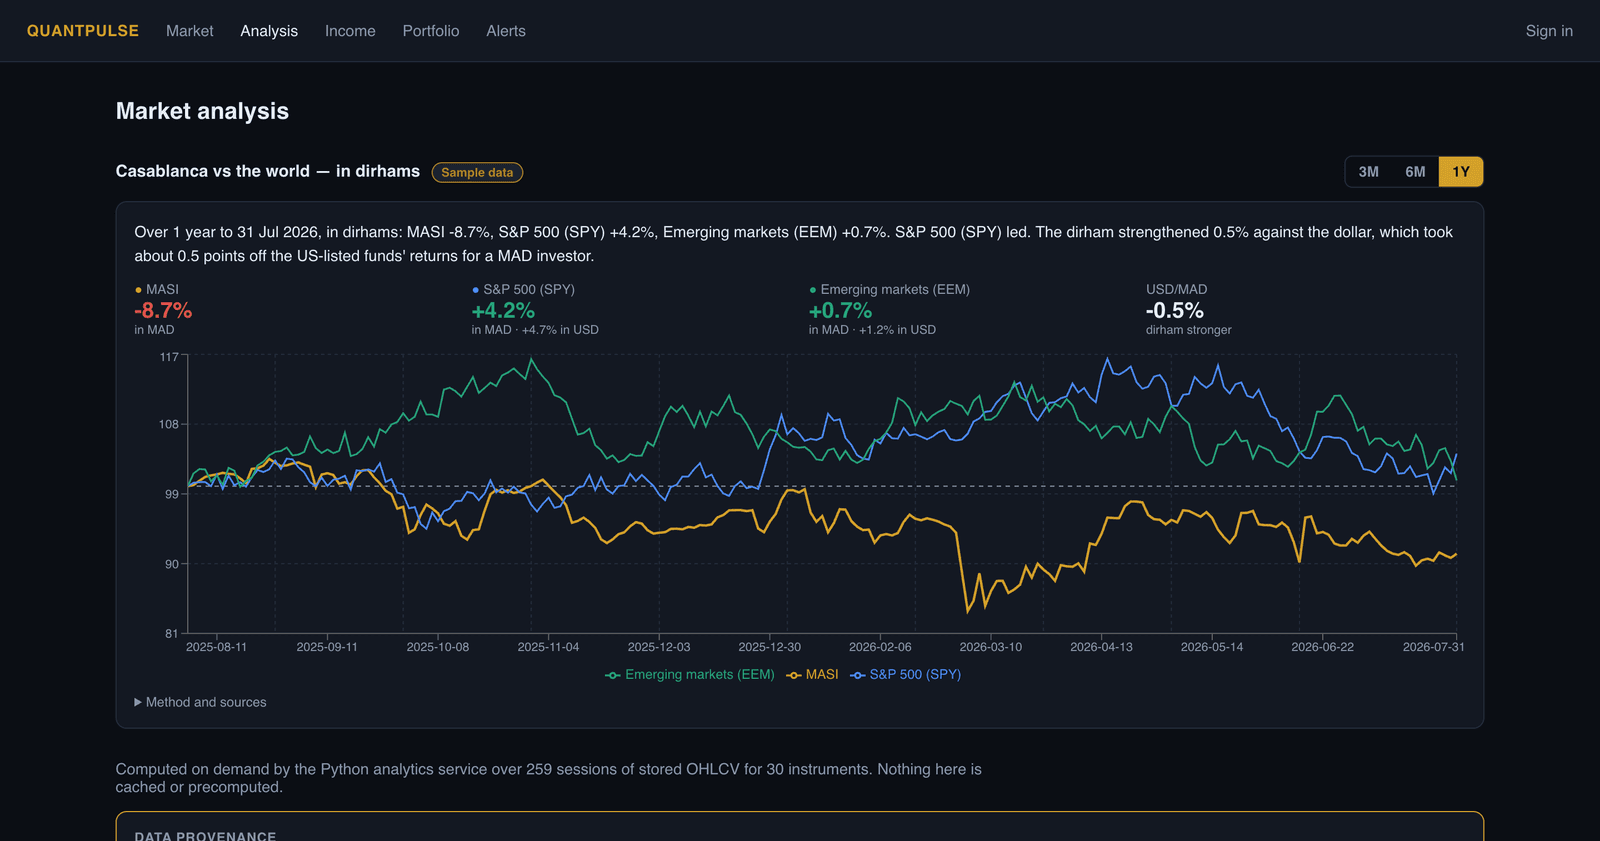
Casablanca face au monde
Casablanca face au monde — Le MASI comparé au S&P 500 et au MSCI Emerging Markets, ramenés à la même devise et à la même date de départ, calculé à la demande sur 259 séances stockées — rien n'est mis en cache ni précalculé.
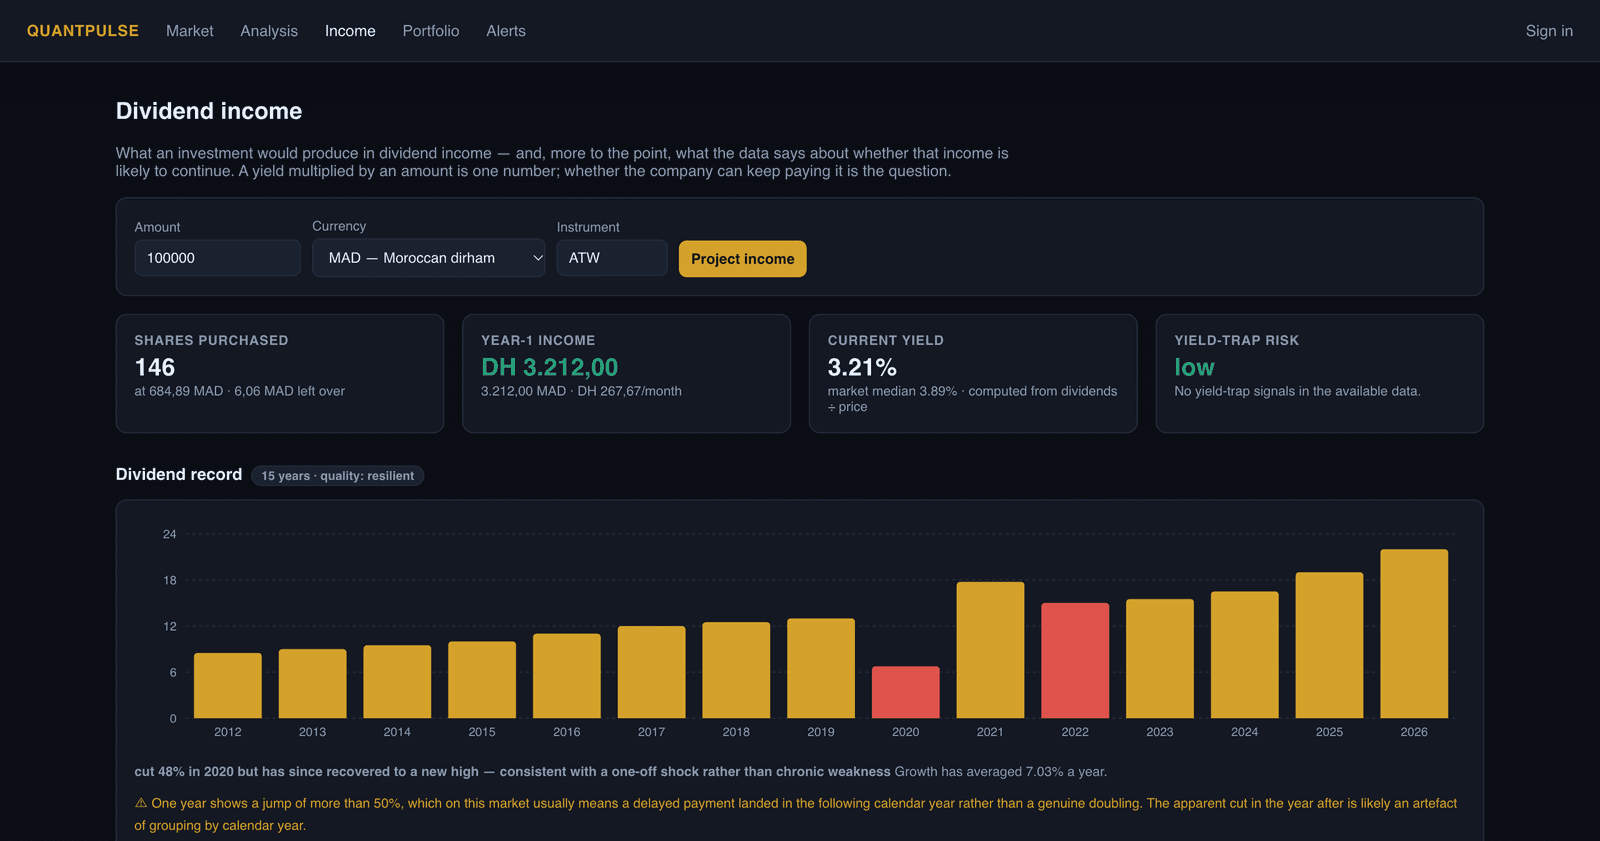
Revenu de dividendes
Revenu de dividendes — Un rendement multiplié par un montant donne un chiffre ; la question qui compte est de savoir si le versement va durer — l'historique sur 15 ans signale la coupe de 2020 comme un choc ponctuel plutôt qu'une faiblesse chronique.
Suivi de portefeuille
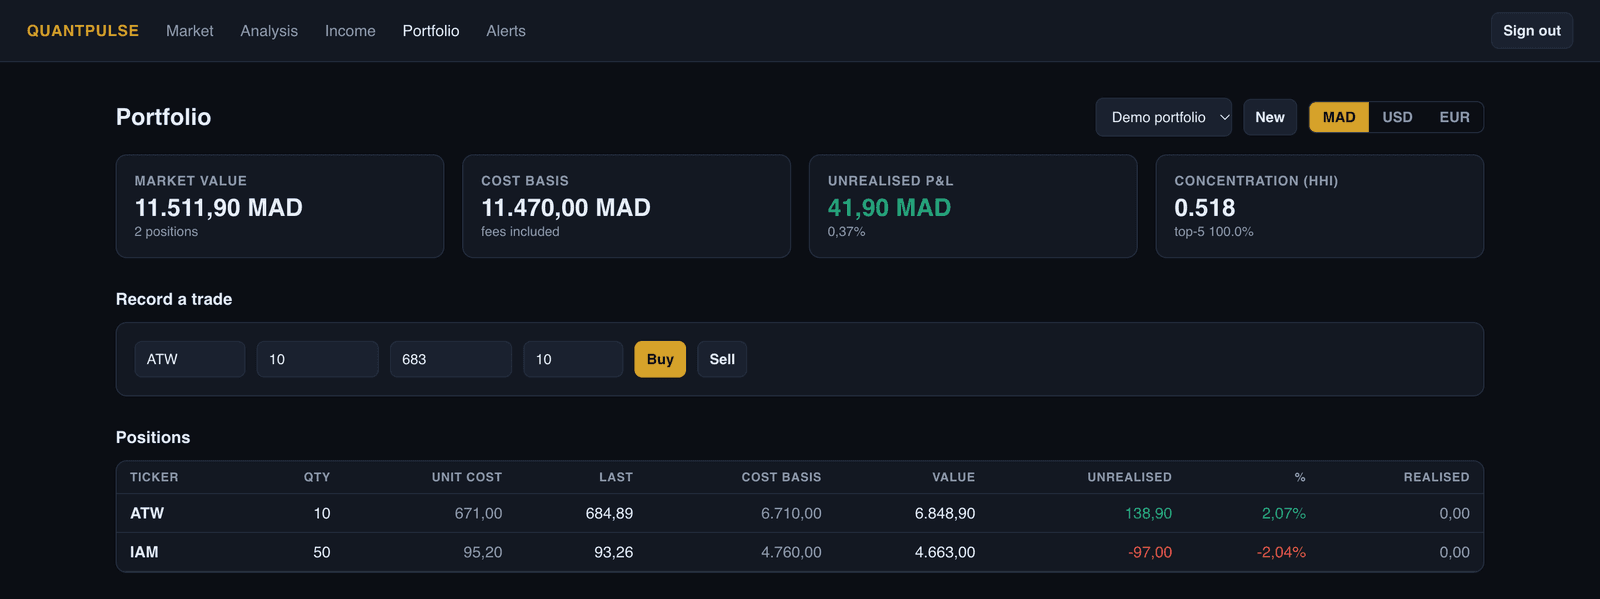
Suivi de portefeuille — Positions, prix de revient et plus-value latente sur un historique de transactions réel, valorisés au choix en MAD, USD ou EUR.
Alertes de prix
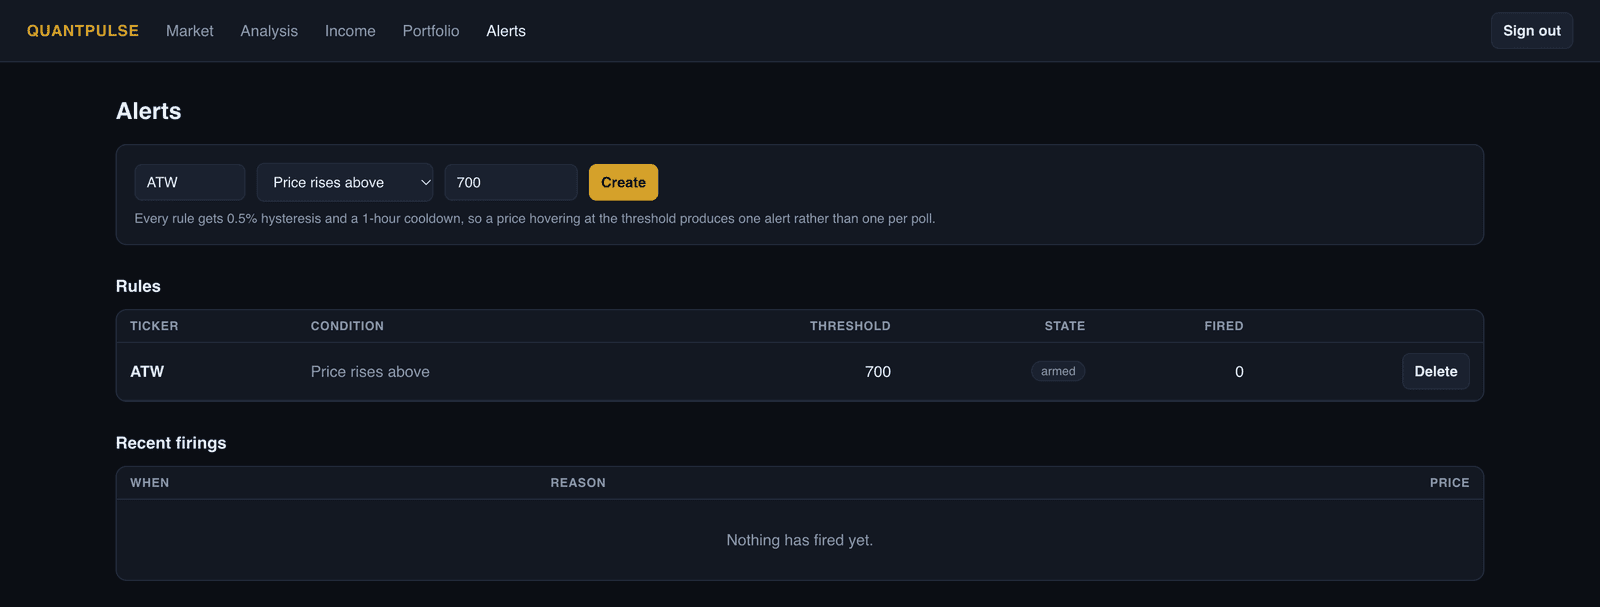
Alertes de prix — Une règle armée sur ATW au-dessus de 700 MAD — une hystérésis de 0,5 % et un délai de grâce d'une heure évitent qu'un cours qui oscille autour du seuil ne déclenche une alerte à chaque interrogation.

Architecture

API Drahmi100 requêtes/jour · différégouverneur de quota · disjoncteur · cache L1+L2qp-marketdataseul propriétaire du fluxqp-quantPython · ACP, Monte-Carlooutbox transactionnelRabbitMQexchange topic · DLQ · parking lotqp-portfolioarithmétique monétaireqp-alertstraitement de fluxqp-apiBFF · seul service joignableqp-webtableau de bord Next.jsun schéma et un rôle de connexion par service — aucun droit inter-schémas

Un seul service possède le flux limité en quota ; tout l'aval apprend l'état du marché par des événements, jamais depuis le fournisseur.

Quatre services Spring Boot et un service Python, chacun avec une raison d'être séparé.

  • qp-marketdata est le seul composant qui parle au flux limité en quota et le seul à écrire des données de marché. Un seul endroit où dépenser une requête signifie un seul endroit où faire respecter un budget. Devant le fournisseur : un gouverneur de quota, un disjoncteur Resilience4j et un cache à deux niveaux (Caffeine en mémoire, Redis partagé) dont les TTL sont calés sur le délai des données en amont.
  • Outbox transactionnel. L'écriture de la donnée et la publication de l'événement sont une seule décision atomique. Sans cela, un crash entre les deux laisse la base et le reste du système durablement en désaccord.
  • RabbitMQ — un exchange topic déclaré explicitement, avec des files de lettres mortes et un parking lot pour les messages qui échouent en boucle.
  • qp-portfolio possède l'arithmétique monétaire et l'intégrité transactionnelle ; qp-alerts fait du traitement de flux. Les deux apprennent l'état du marché par des événements.
  • qp-api est un backend-for-frontend avec JWT et server-sent events, et le seul service que le navigateur peut joindre. qp-web est le tableau de bord Next.js.
  • qp-quant (Python, FastAPI, NumPy/scikit-learn) fait les analyses qui seraient pénibles sur la JVM.
  • Une instance Postgres, un schéma et un rôle de connexion par service, sans droits inter-schémas. L'historique OHLCV est partitionné par mois. La planification tient compte des horaires de marché en Africa/Casablanca, avec ShedLock pour qu'une instance dupliquée ne dépense pas le quota deux fois. Micrometer → Prometheus → Grafana de bout en bout.

Décisions & compromis

Un schéma par service, imposé par la base de données

Des services séparés partageant un schéma, c'est la manière classique de construire un monolithe distribué : la frontière existe sur le schéma d'architecture et nulle part ailleurs. Ici chaque service a son schéma et son rôle de connexion, et aucun droit inter-schémas n'existe — qp_portfolio qui interroge market.* échoue sur un permission denied. L'anti-motif n'est pas déconseillé : il est impossible par construction. Le coût, c'est que partager une donnée exige un acte délibéré — un événement, ou un appel d'API. C'est précisément le but.

Un outbox transactionnel plutôt qu'une publication après commit

Publier juste après le commit tient en une ligne et se révèle faux d'une manière qui n'apparaît qu'en cas de panne : un crash entre les deux, et la ligne existe alors que l'événement n'a jamais eu lieu. Écrire l'événement dans la même transaction que la donnée, puis le relayer séparément, rend les deux cohérents par construction. Le prix est une livraison at-least-once, donc chaque consommateur doit être idempotent — une propriété que je voudrais de toute façon, et bien plus facile à raisonner qu'une base silencieusement divergente.

Un service Python séparé pour l'analyse

Mélanger les runtimes est un coût qu'on paie pour toujours : il fallait le justifier. La justification, c'est que l'ACP, le clustering hiérarchique, la simulation de Monte-Carlo et l'optimisation de Markowitz sont un problème résolu en NumPy/SciPy/scikit-learn et un projet de recherche sur la JVM. qp-quant lit les OHLCV via l'API HTTP de qp-marketdata plutôt que d'aller dans sa base : la frontière est un contrat, pas une table partagée.

Les prévisions renvoient des distributions, jamais un point

Le service d'analyse renvoie des bandes de percentiles et des probabilités de résultat issues d'un Monte-Carlo sous GBM — jamais « le prix sera X ». À côté tourne un backtest de calibration walk-forward, hors échantillon, qui indique si les intervalles du modèle sont honnêtes.

Ce backtest a gagné sa place tout de suite : il a trouvé un vrai défaut dans la première implémentation, où une volatilité équipondérée produisait des intervalles à 90 % contenant 100 % des résultats — bien trop larges pour être utiles, et faux dans le sens flatteur. Il a conduit au passage à l'EWMA. Le reste de surconfiance sur l'instrument le plus volatil est signalé, pas dissimulé.

Ce qui a été difficile

La sémantique de livraison. At-least-once signifie que le consommateur de persistance verra tôt ou tard deux fois le même tick, et une ligne de prix dupliquée est un graphique silencieusement faux, pas un plantage — le pire mode de défaillance qui soit. Des écritures idempotentes sur une clé naturelle ont réglé le problème, et cela a changé ma façon d'écrire des consommateurs : partir du principe qu'on sera appelé deux fois.

La limite de débit a été l'autre difficulté, d'une façon inattendue. Lire attentivement la documentation du fournisseur a rapporté plus que n'importe quelle astuce de cache — et la documentation et l'API réelle divergent sur 11 points documentés, que j'ai dû trouver et consigner un par un. Développer contre un jeu de fixtures enregistré depuis le vrai service était la seule façon d'avancer sans brûler le budget du jour avant midi.

Résultat

Une plateforme qui tourne et couvre toute la cote dans un budget qui exclut la conception naïve, avec 69 tests automatisés et un mvn verify complet qui dépense zéro appel d'API. Les analyses ont été confrontées à la réalité plutôt que supposées : les métriques de risque correspondent aux chiffres publiés par le fournisseur à environ 2 % près, et le clustering ne voit jamais les étiquettes de secteur — là où il rejoint la classification sectorielle officielle, cet accord est donc une preuve et non une hypothèse intégrée d'avance.

C'est le premier système où j'ai choisi les modes de défaillance exprès, au lieu de les découvrir.

La suite

Je ne déploie pas ce projet publiquement. Six services, un broker et trois bases de données représentent une infrastructure réelle à payer et à maintenir, pour un projet dont le rôle est d'être lu, pas de servir du trafic. Les captures ci-dessus montrent le système qui tourne réellement ; le RUNBOOK donne les mêmes commandes, dans l'ordre, pour le faire tourner en entier depuis un clone propre en quelques minutes — sur les fixtures enregistrées, sans aucun appel au vrai fournisseur. Ce qui reste à faire sur le système lui-même : le traçage distribué à travers la frontière du broker, parce qu'un système entièrement asynchrone sans traçage est une mauvaise combinaison ; et un chemin de rejeu pour le parking lot, pour qu'un message empoisonné soit récupérable et pas seulement contenu.